研究笔记 / 具身智能
具身智能 RSI 调研报告
调研报告 · 中英双语RSI 的关键不在循环多少次,而在什么变化被下一轮继承,以及这种继承带来了什么收益。
本文从任务系统与改进过程两个角色出发,梳理四篇具身论文,再用 Ai2 的评测研究和 AIDE² 的点火测试检查证据边界。
核心判断
任务收益、持久更新、改进能力提升,是三个不同的证据问题。
本文审阅的具身案例主要支持 L2;PhysEvo 提供 L3 结构证据。受控条件下的 L3 收益仍需单独检验。
1 · 概念与证据框架
两个功能角色
任务系统(Task system,)负责完成任务,包含模型、工具、技能、记忆与代码。改进过程(Improvement process,)负责诊断失败、提出修改、搜索候选并安排验证。“改进器”是实现这一过程的机制,不一定是另一个模型;同一模型可以承担两个角色。1
执行后修改并保留任务系统,是广义的自我改进;当产生未来改进的方法也被修改、继承,才进一步涉及递归结构。拥有递归结构,不等于已证明改进能力更强。
L1、L2、L3 分别证明什么
| 层次 | 判断对象 | 所需证据 |
|---|---|---|
| L1:任务/产物收益 | 当前答案、程序产物或执行结果 | 当前结果变好;尚无任务系统持久更新的依据 |
| L2:任务系统持久更新 | 模型权重、技能、记忆或执行代码 | 修改被保存,并继续参与后续执行;收益与迁移另报 |
| L3 结构证据 | 产生后续改进的过程 | 诊断、搜索或更新机制发生修改,并被后续改进继承 |
| L3 收益证据 | 改进过程的有效性 | 同一起点、可比预算与评价条件下,新过程更有效地产生后继系统 |
这里的分级是本报告的操作性判断框架。“强 L2”只表示持久更新与任务收益的实验支持较充分,不是新增正式等级。是否保留了修改,与修改能否泛化,是两件事;泛化有限不能反推出“没有更新”。
本文的关键术语
| 术语 | 含义 |
|---|---|
| Agent(智能体) | 能观察、决策并执行任务的完整系统,不等于单独一个模型 |
| Harness(执行框架) | 组织模型调用、工具、上下文与任务流程的外围代码和机制 |
| Skill(技能) | 可重复调用的能力单元,可由程序或学习策略实现 |
| Policy(策略) | 根据观察或状态决定行动的规则或模型 |
| Rollout(执行回合) | 实际运行策略,并记录动作、状态与结果 |
| Retention(继承/保留) | 经验证的修改被后续任务或改进轮次继续使用 |
| Held-out evaluation(留出评测) | 用未参与相关开发与版本选择的数据或任务检验结果 |
2 · 六机制与统一循环
Wu 等的综述按更新对象组织研究。六机制回答“改哪里、怎样改”,L1/L2/L3 回答“证明了什么”。二者不能互相替代。1
| 机制 | 更新内容 |
|---|---|
| Weights(权重) | 通过训练改变模型参数 |
| Tasks(任务) | 调整下一轮练习、探索或采集的内容 |
| Memory(记忆) | 保存经验,并在后续决策中检索使用 |
| Programs(程序) | 修改工具、技能、提示或流程代码 |
| Feedback(反馈) | 改变用于判断结果的信号或评价机制 |
| Improver(改进过程) | 修改诊断、搜索与产生下一次更新的方法 |
01 · 执行任务系统产生经验
02 · 诊断定位失败与薄弱条件
03 · 修改提出候选更新
04 · 验证比较收益、退化与成本
05 · 继承下一轮使用获准的修改
软件与机器人共享这类循环。机器人额外承担真实交互、场景复位、硬件磨损与人工介入的成本。反馈可以改进,但用于最终判断的评价标准必须受到保护,不能让系统靠改评分规则获得虚假提升。
3 · 两类更新对象,一种研发组织方式
物理 RSI 呈现的是一组机制的汇合,而不是一个统一的标准算法。观察失败并归因后,可以修复执行框架/技能、定向获取经验、更新策略权重,再验证并保留;这些分支可以组合。
- 执行框架与技能更新:经验进入工具、代码、记忆与可复用技能,模型权重可以冻结。PhysEvo、RoboRSI 属于重点案例。
- 模型与策略更新:失败改变下一轮数据,数据训练出新策略,新策略产生新的失败分布。EmbodiRSI 属于重点案例。
- 自动化研发:描述谁提出方案、运行实验和选择结果。ENPIRE 可以改程序,也可以组织策略训练,因而与上述两类对象都有交集,不另立第三种并列更新对象。
4 · 四篇具身论文
PhysEvo:执行工具与诊断资源都能更新
机制:冻结模型权重,根据执行反馈修改工具和技能。Task Harness 服务于任务执行;Meta Harness 服务于诊断和改进,诊断后续失败的工具也可以被改写并保留。
保留:可复用执行能力与诊断资源。
证据:强 L2 + L3 结构证据。仍需从相同任务系统起点、在可比总预算下,独立比较新旧改进器产生后继系统的效率。2
RoboRSI:让技能修正能够积累与复用
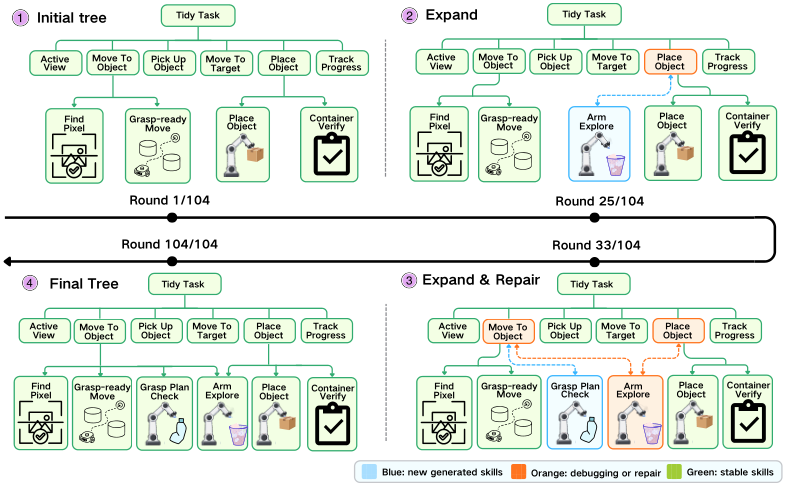
组织:人给目标、约束和纠正,系统维护任务—技能层级。Manager 管理与审核,Planner 规划,Engineer 实现和调用技能,Reviewer 检查与诊断;这是角色分工,不要求分别训练四个模型。
TSR(Top-Down Skill Refinement,自上而下的技能精进):定位失败节点 → 修改责任分支 → 检查新任务与原有能力 → 发布可复用版本。
保留:技能代码、接口、检查规则与复合技能。
证据:强 L2。真机持续开发 104 轮,并有仿真复用与迁移实验;尚未建立 L3 收益证据。论文另有 ACT(一次预测一段连续动作的策略)训练实验,不能据此说主循环每轮都训练通用模型。3
EmbodiRSI:让失败改变数据,再改变策略
循环:执行策略 → 发现失败 → 定向纠错/补数据 → 训练新策略 → 再执行。
六个模块:Real2Sim 重建仿真;Trajectory Generation 生成轨迹;Policy Training & Rollout 训练并执行;Collaborative Error Correction 生成纠错轨迹;Adaptive Data Collection 针对弱点补数据;Sim2Real 用少量真实经验适配真机。
训练与测试:训练时,GPT-5.5 智能体组织数据和纠错,规划工具生成轨迹,训练程序更新机器人策略;真机微调有人类参与。正式测试关闭外部接管、规划器恢复和人工纠正,由训练后的策略独立执行。
结果:3 个场景、14 个子任务,每子任务 400 条仿真轨迹 + 10 条真实纠正轨迹,真机场景均衡成功率 83.1%;使用 200 条真实示范的对照为 75.0%。场景均衡指各场景按相同权重汇总。保留的真实训练轨迹数为对照的 1/20,不等于总成本为 1/20。
证据:强 L2。数据与策略权重被保留;策略变好不等于采集/训练方法自身已升级,调度大模型的权重也不随该循环训练。4
ENPIRE:自动化组织真实机器人研发
组织:研究智能体提出方案、修改代码、运行真实实验,再按固定评价反馈筛选。
更新:策略程序、训练算法代码、训练后的权重及研究经验。环境建立后的复位、成功判定与安全接口保持固定。
关系:改程序与训练策略均可成为研发选择;“自动化研发”描述组织方式,不是与代码、权重并列的第三种对象。
证据:L2 + 改进资源继承线索。研究经验的保留与迁移值得单独分析,但自动化实验本身不能代替 L3 收益检验。5
5 · 主要工作对比与证据等级
| 工作 | 主要保留什么 | 本报告的证据判断 |
|---|---|---|
| PhysEvo | 执行工具、技能、诊断资源 | 强 L2 + L3 结构;改进器收益另验 |
| RoboRSI | 技能代码、接口与检查规则 | 强 L2;任务收益不等于改进能力提升 |
| EmbodiRSI | 数据集与策略权重 | 强 L2;采集/训练方法的自升级未由成功率证明 |
| ENPIRE | 策略/训练代码、权重与研究经验 | L2 + 继承线索;需要分开审计策略和研发过程 |
横向比较应同时报告:更新对象、继承内容、预算、真实/仿真环境、留出验证与局限。不同环境、数据量与评价指标下的成功率不能直接排成能力榜单。
6 · 软件对照:AIDE²
AIDE² 把内层研究智能体作为任务系统 ,把改写和筛选它的外层过程作为 。外层把内层改好,并不自动证明外层自身变强。
主实验持续 8 天,演化轨迹包含 100 个节点,接受 7 次重写,私有评分从 0.703 升至 0.778,并进行外部基准测试。私有评分参与候选选择,因此不能把它等同于从未用于开发的最终测试。论文另外设置点火测试,专门问改进后的智能体是否更擅长承担外层改进角色。6
7 · Ai2:区分演化收益与更多搜索预算
Ai2 是 Allen Institute for AI。其评测论文比较平行采样、顺序修订、跨任务执行框架演化与单任务框架适应,要求反馈和推理预算可比。7
| Terminal-Bench 设置 | 平行采样 | 执行框架演化 |
|---|---|---|
| 无单元测试,平均 pass@1 | 72.3% | 67.4% |
| 有单元测试,平均 pass@1 | 82.0% | 69.7% |
Terminal-Bench 是终端操作任务评测;pass@1 是单次输出的通过表现,但整套方法仍可能用反馈选择候选。论文用三个模型、两次独立运行,采样/迭代预算参数 。
留出实验采用 45 个训练、10 个验证、34 个测试任务;三模型平均 pass@1 为 63.2% → 63.2%,未显示平均提升。
结论不是“框架演化无效”。论文 v4 还报告长时程交互游戏中的正例,说明任务、反馈粒度与预算会改变结果。机器人研究同样需要分别记录模型调用、交互、复位、训练与人工介入,避免把更多资源误算成机制优势。这是本文对具身研究的推论,不是 Ai2 已完成的机器人实验。
8 · 点火测试:改进器自身有没有变好
先固定起点、预算与评价
设 为共同的初始任务系统, 为改进过程, 为可比资源预算; 为接受的后继系统,上标 仅表示更新版本。 是固定评测协议下的质量分数; 表示对约定的任务抽样和运行随机性取平均。
表示平均质量增益。再用 、 区分新旧改进器,以 表示改进器收益差(imp 是 improver 的缩写):
可信的 L3 收益需要支持 ,并报告重复实验与不确定性。这是本报告的说明性记号,不是 AIDE² 的原始评分公式。预算中的次数、耗时与费用应分别配平,不直接相加。
AIDE² 的实际对照
两组都从同一个内层版本 AIDE₄₇ 出发:一组由演化后的 AIDE₄₇ 承担外层改进,另一组由人类工程师设计的 AIDE_human 承担外层。后者是智能体系统,不是人类现场代做。每组 3 个随机种子,每个种子 50 步。6
参照改进器
AIDE_human
0.782平均终点分数
演化后的改进器
AIDE₄₇
0.780平均终点分数
作者结论:尚无定论。候选改进器较早接近最终分数的迹象,不能凭三个种子建立稳定优势。点火测试比较的是“谁更擅长产生下一次改进”,不要求 AI 必须战胜人类。
9 · 总结:回到 Survey 的三个问题
- 改了什么?当前产物、任务系统,还是产生修改的过程。
- 保留了什么?更新是否进入后续任务或改进轮次。
- 证明了什么?任务收益、可迁移收益与改进器收益分别需要证据。
本文所引具身案例展示了持久系统更新;PhysEvo 进一步提供改进过程的结构证据。不能只凭更高的机器人成功率,认定改进器也更强。这限定于本文审阅的版本与实验,不是对全部具身研究作不存在性判断。
参考文献与飞书原文
- Hao Wu et al. Recursive Self-Improvement in AI: A Survey. 2026,预印本。
- Wenqing Tian et al. PhysEvo: Astra Can Act, Let It. 2026。
- Zimo Wen et al. RoboRSI: Stable, efficient, and reusable robot self-evolution in complex real-world environments. 2026。
- Haoran Lang et al. EmbodiRSI: Recursive Self-Improvement for Data-Efficient Robot Adaptation. 2026,§4.3 与附录。
- Wenli Xiao et al. ENPIRE: Agentic Robot Policy Self-Improvement in the Real World. 2026。
- Dhruv Srikanth et al. AIDE²: Recursive self-improvement of AI research agents. 2026,点火测试见 §3.6。
- Yike Wang et al. Rethinking the Evaluation of Harness Evolution for Agents. 2026,v4;§4 表 1–3、§5。
本文是调研报告的博客阅读版。完整总表、补充论文、原始图示和历史说明保留在 飞书《具身智能 RSI 调研报告》(访问取决于原文权限)。本文可独立阅读;网页与飞书分别维护,飞书后续编辑不会自动同步到本文。
资料核验截至 2026-10-23;本次网页整理 2026-10-27。证据等级是本文的综合判断,论文实验与本文推论已分别说明。