HCI
Lab 2 · 3DGS:任务解释与真实 Unity 结果
公开模型导入与渲染已完成 · 课堂指定数据要求待确认2026 年 10 月 29 日实际执行。 已把公开的预训练高斯模型导入 Unity,生成资源、构建 Windows 查看器,并保存三个视角的真实画面。本次没有自己拍摄照片、没有训练重建模型。老师是否要求指定数据或个人拍摄重建,现有材料没有说清楚。
先分清这是哪门课、哪项实验
HCI 总课件第 4 页把“Unity Mobile App/VR/3DGS”列在编程内容中;当前课程文件夹另有 Mohamed ABDUL GAFOOR 的 19 页《3D Gaussian splatting in unity》课件。这是本次实验的来源。没有使用 ACV3D 课程的图片或课件。
“Lab 2”是已有课程记录对第二周 3DGS 实验的称呼。不要把它与同一份 HCI 总课件第 166 页的 Lab 3:Unity 应用与 ML agent 混为一项。
3DGS 到底在做什么
可以把它想成:用许多带颜色、透明度和方向的小椭球,组成一个可以换角度看的场景。它们是用于画面的高斯表示,不是一堆有实体碰撞的小球。
课件包含两段流程:
- 制作模型: 多角度照片 → 数据准备与优化训练 → 高斯模型文件。
- 展示模型: 已有高斯模型文件 → Unity 资源 → 渲染显示与观察。
本次完成的是第二段。“需要数据”指需要那个已有模型文件,并不是要求你额外编造实验数据。课件只有步骤和截图,没有附这个模型,因此选择了公开示例。
课件把每个高斯描述为四类属性:位置;形状与朝向;不透明度;颜色。颜色可以用球谐函数(spherical harmonics)表示外观随观察方向的变化。所以随便载入一份点云,并不等于载入训练好的高斯模型。训练时把渲染图与参考图像比较,调整模型以缩小差异;课件还讲到在需要的地方增加细节、删除几乎透明的高斯。
课件各页讲了什么
- 第 2–4 页:用高斯基元而不是三角形来渲染。
- 第 5–9 页:参数、训练、增删高斯、局限,以及随视角变化的颜色。
- 第 10 页:原始训练代码库,以及需要事先准备好 COLMAP 或 NeRF Synthetic 数据集的训练命令。
- 第 11–17 页:把高斯模型导入 Unity 并显示。
- 第 18–19 页:Brush 与 Rerun 两个补充工具。
如果之后确认需要用照片自己训练:第 10 页的示例命令要求准备好的数据集,不是随便一个照片文件夹。原始实现使用基于 CUDA 的流程;第 18 页提到的 Brush 是另一款重建工具,需要对照课堂要求确认;第 19 页链接了 Rerun。列出这些工具不代表都要安装。
本次真正用了什么
| 项目 | 实际使用 |
|---|---|
| Unity | 已安装的 6000.6.4f1 |
| 渲染管线 | URP 17.6.0 |
| 显卡与图形接口 | AMD Radeon 780M / Direct3D 12 |
| 渲染器 | 课件指定的 UnityGaussianSplatting,已固定源码版本 |
| 输入 | Niantic 公开的 hornedlizard.spz,约 18 MB |
| 导入结果 | 786,233 个高斯,Medium 预设 |
| 结果证据 | 1280 × 800 的三个实际运行视角、导入和运行记录 |
课件演示的是 PLY,本次使用渲染器同样支持的 SPZ。模型由公开项目提供,不能写成“我自己拍摄、训练得到”。
实际过程与遇到的问题
先建立独立实验工程,使用公开示例和课件指定渲染器,没有修改停电救援。首次精简包引用时遗漏了 Unity 内置 XR 模块,导致渲染器中的 XRSettings 编译错误;补齐引用后继续导入。
通过 Editor 脚本调用渲染器菜单背后的同一个资源创建实现,把 SPZ 生成 GaussianSplatAsset,再绑定到 GaussianSplatRenderer。这个过程是自动化执行的,不假装成手动点击操作。
随后设置场景、相机和 Direct3D 12,构建并实际运行 Windows 查看器。模型包含远处的高斯,完整边界约为 ±200;按完整边界取景会让主体过小,因此根据中心位置分布调整观察目标和距离,没有删除高斯。隐藏窗口截图曾得到无效或纯黑图,未计为成功;改成可见运行并读取相机渲染纹理后,得到有效的三视角图像。
实际结果
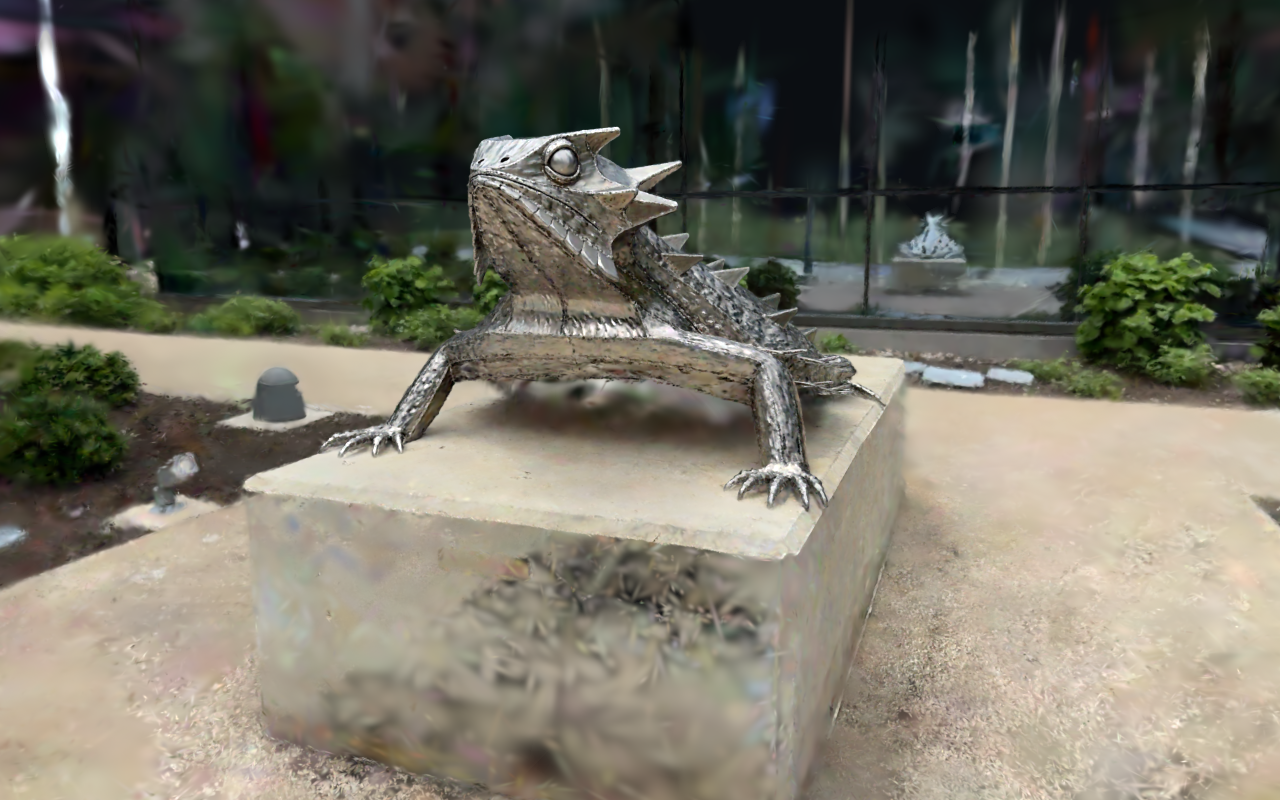
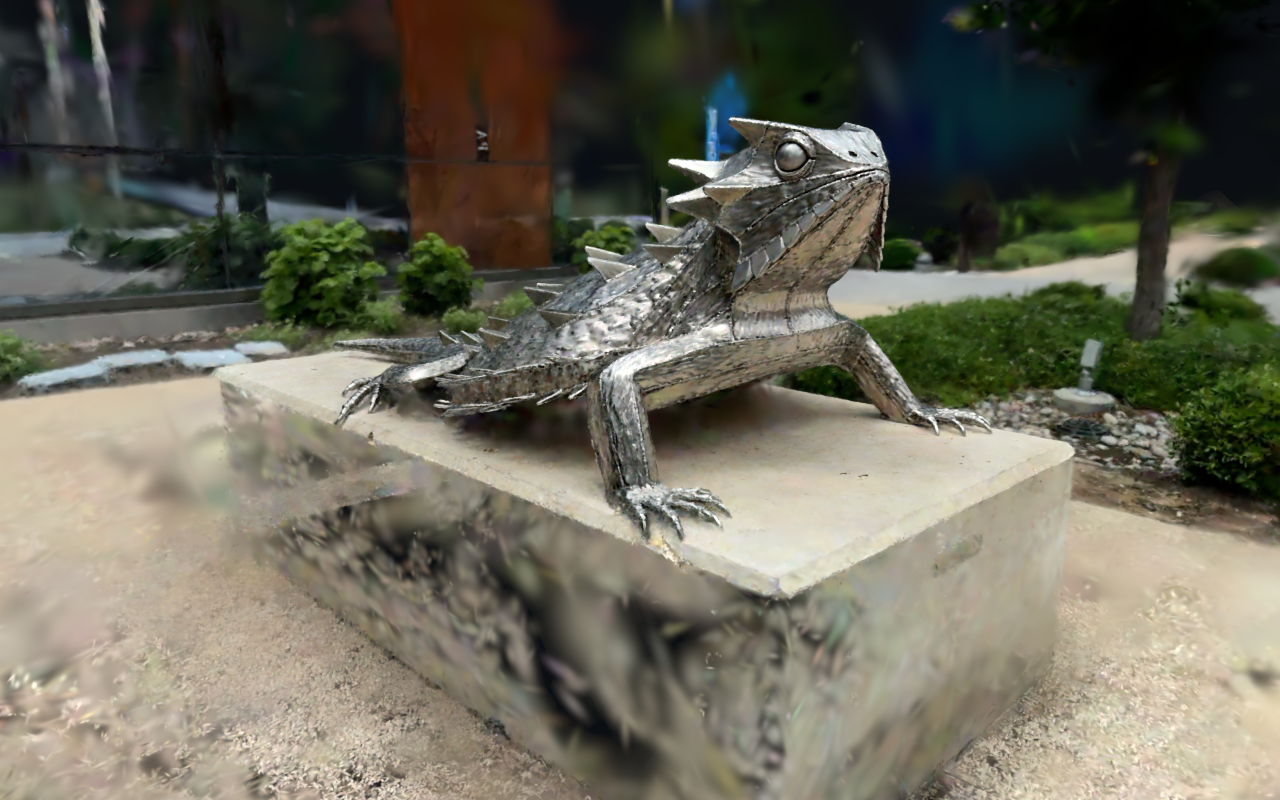
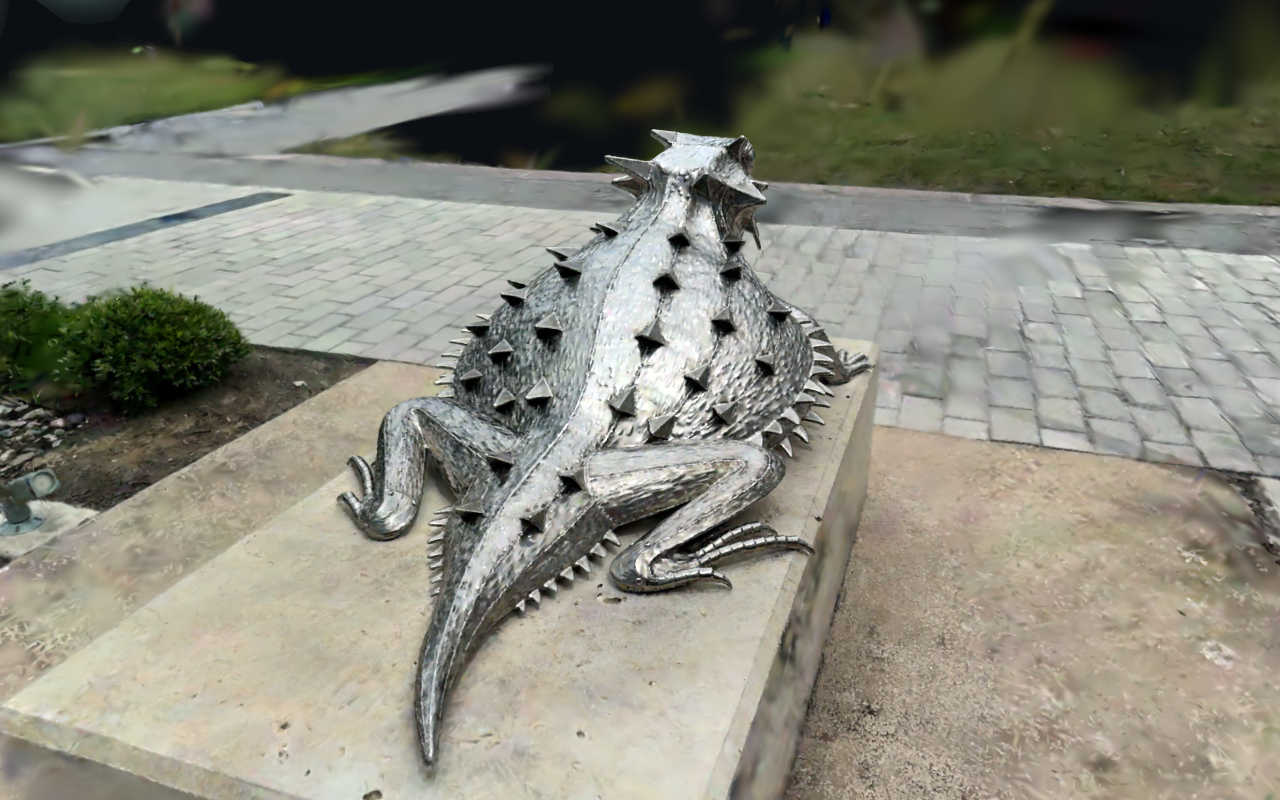
以上来自实际程序输出,不是老师课件截图或 AI 绘图。三个视角能辨认雕塑的两侧和背部,底座和周围地面也能看到模糊及不完整细节。导入资源有效,程序使用支持计算着色器的图形设备。运行日志仍出现 D3D12 上传缓冲大小警告,因此不声称“无警告”;没有测量重建精度或宣称固定帧率。
这和 Lab 3 的 agent 有什么区别
本实验显示的是三维场景。3DGS 的“训练”是调整位置、形状、透明度和颜色,让渲染图像接近照片。Lab 3 的 ML agent 则涉及角色如何根据观察决定动作;若使用强化学习,优化的是得到奖励的行动策略。一个是场景表示,一个是角色决策,不能把它们算成同一次训练。ML 是 machine learning 的缩写,不表示必须 multi-agent。
与 Homework 配套看,还差什么
第二组一起核对 HW2+Lab 2:HW2 的研究者、Ultimate Display 阅读回应和输入技术分析已完成正文并核对主要来源;本页补上实际 Unity 展示结果。HW2 仍需要本人理解和复核,不能把 AI 辅助写作说成本人设备使用或真人实验。
视觉场景逼真,不代表已有碰撞、可选择的物体或清晰的导航。这正好连接 HW2 的显示与交互讨论:HCI 关注人如何理解、控制并获得反馈。
本次已完成公开模型的导入与展示流程。课堂指定数据是否必用、是否必须自己拍摄训练,仍待课程说明确认;没有把这两个未知条件标成已完成。原总课件还保留旧年份及不一致的截止日期,不据此判断今年截止时间。
来源:HCI 提供的 3DGS 课件第 2–19 页;课件指定渲染器(使用说明);3DGS 原始实现、Brush、Rerun(课件提到,本次未使用);Niantic 公开模型。实验执行与记录使用 AI 辅助。